Do que se trata#
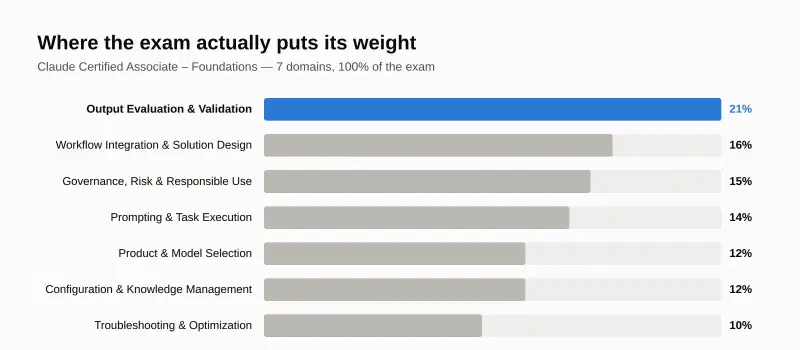
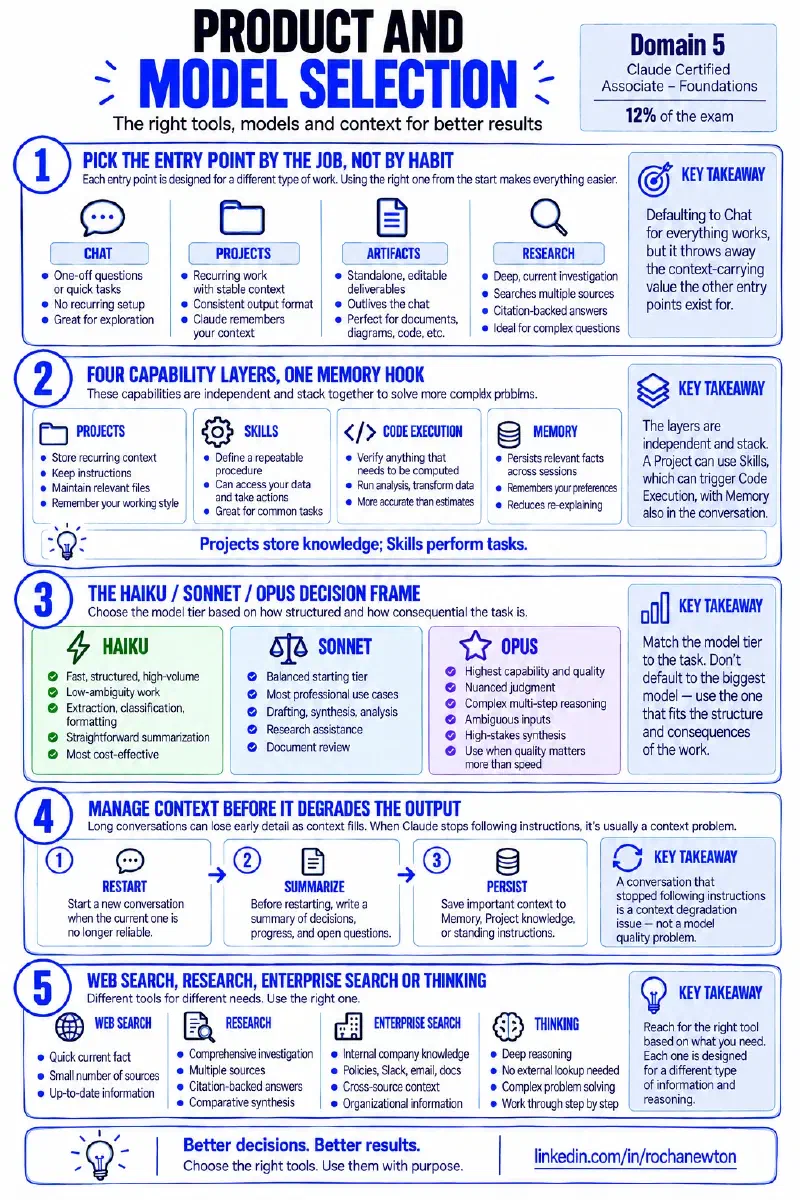
O Domínio 5 da prova Claude Certified Associate – Foundations é Seleção de Produto e Modelo. Vale 12%. O enquadramento: antes mesmo do prompting começar, quatro decisões já definem o teto de qualidade da sessão — o ponto de entrada certo, a camada de capacidade certa, o nível de modelo certo, a estratégia de contexto certa. Errar essas quatro e nenhuma quantidade de polimento no prompt conserta. Acertar essas quatro e o prompt precisa fazer muito menos trabalho.
Ponto-chave 1: escolha o ponto de entrada pelo trabalho, não pelo hábito#
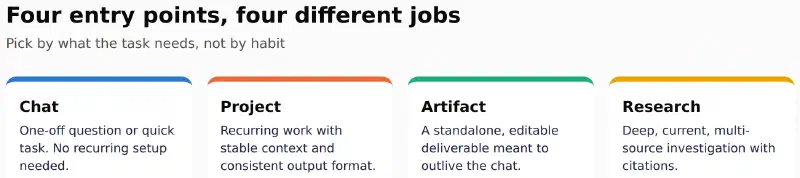
O Chat é para uma pergunta pontual ou tarefa rápida sem necessidade de configuração recorrente. Um Project é para trabalho recorrente com contexto estável e formato de saída consistente. Um Artifact é para um entregável autônomo e editável, feito para durar além do chat. O Research é para uma investigação profunda, atual e multi-fonte, com citações. Recorrer ao Chat para tudo é o descompasso mais comum — funciona, mas joga fora o valor de carregar contexto que os outros três existem para oferecer.
Existe um teste rápido para saber se vale a pena construir um Project: a tarefa se repete, o contexto de fundo é estável, o formato de saída é consistente? Se duas ou mais dessas coisas forem verdadeiras, um Project geralmente se paga.
Ponto-chave 2: quatro camadas de capacidade, um gancho de memória#
Os Projects carregam contexto recorrente e configuração permanente. As Skills definem um procedimento repetível. A Code Execution verifica qualquer coisa que precise ser calculada em vez de estimada. A Memory mantém fatos relevantes entre sessões. As camadas são independentes e se combinam — um Project pode usar Skills, que podem acionar Code Execution, em uma conversa em que a Memory também tem contexto. O atalho que vale lembrar: Projects guardam conhecimento; Skills executam tarefas.
Ponto-chave 3: o frame de decisão Haiku / Sonnet / Opus#
Três níveis, combinados com quão estruturada e quão consequente é a tarefa. O Haiku se encaixa em trabalho rápido, estruturado, de alto volume e baixa ambiguidade — extração, classificação, formatação, resumo direto. O Sonnet é o nível balanceado de partida para a maioria do trabalho profissional — redação, síntese, análise, apoio a pesquisa, revisão de documentos. O Opus justifica seu custo quando o teto de qualidade importa mais que a velocidade — julgamento sutil, raciocínio complexo em múltiplas etapas, entradas ambíguas, síntese de alto risco.
flowchart TD
    A[Nova tarefa] --> B{Estruturada, alto volume,
baixa ambiguidade?}
    B -->|Sim| C[Haiku
extração, classificação, formatação]
    B -->|Não| D{A maioria do trabalho profissional:
redação, análise, síntese?}
    D -->|Sim| E[Sonnet
nível balanceado de partida]
    D -->|Não, precisa de julgamento
sutil ou de alto risco| F[Opus
teto de qualidade acima da velocidade]

    style C fill:#86b6ef,stroke:#5598e7,color:#0b0b0b
    style E fill:#2a78d6,stroke:#1c5cab,color:#fff
    style F fill:#104281,stroke:#0d366b,color:#fff
A pegadinha da prova que vale lembrar: não recorra ao Opus só porque o assunto soa importante. Se a tarefa é altamente estruturada, inequívoca e de alto volume, o Haiku costuma ser a resposta melhor, independente de quão relevante o tema pareça.
Ponto-chave 4: gerencie o contexto antes que ele degrade o resultado#
Sessões longas perdem detalhes iniciais conforme o contexto enche e é comprimido. Quando uma conversa que funcionou bem por muito tempo de repente para de seguir uma instrução inicial, o sinal é degradação de contexto, não um problema de qualidade do modelo. A correção tem três movimentos: reiniciar uma nova conversa quando a atual não é mais confiável; antes de reiniciar, escrever um resumo de estado com decisões, progresso e questões em aberto, e começar a nova conversa a partir dele; e persistir qualquer coisa que deva durar além da conversa na Memory, no conhecimento do Project, ou nas instruções permanentes, em vez de reexplicar toda vez.
Ponto-chave 5: web search, Research, Enterprise Search, ou Thinking#
Quatro ferramentas diferentes de busca e raciocínio, fáceis de escolher errado. O web search é para um fato atual rápido a partir de poucas fontes. O Research é para investigação abrangente, multi-fonte, com citações, e síntese comparativa. O Enterprise Search é para conhecimento organizacional interno — políticas, Slack, e-mail, documentos, contexto da empresa entre fontes. O Thinking é para raciocínio profundo em que informação externa não é a necessidade central.
| Necessidade | Recorra a |
|---|---|
| Fato atual rápido | Web search |
| Investigação abrangente multi-fonte | Research |
| Conhecimento interno da empresa entre ferramentas | Enterprise Search |
| Raciocínio profundo, sem busca externa necessária | Thinking |
Conclusão#
O Domínio 5 em uma passada: escolha o ponto de entrada que combina com o trabalho (Chat, Project, Artifact ou Research), saiba qual das quatro camadas de capacidade a tarefa realmente precisa e lembre que Projects guardam conhecimento enquanto Skills executam tarefas, combine o nível de modelo com quão estruturado e consequente é o trabalho em vez de recorrer por padrão ao maior modelo, e trate uma conversa que parou de seguir instruções como um problema de contexto a resolver com reiniciar-resumir-persistir, não um problema de modelo a combater. Essas quatro decisões acontecem antes do prompt fazer qualquer trabalho.
Fontes#
- Claude Platform & Model Foundations — Anthropic Partner Academy
- Claude Certified Associate – Foundations Exam Guide — PDF oficial
Onde isso se encaixa#
Parte 7 de Getting Claude Certified. A Parte 1 cobriu o Framework 4D, a Parte 2 cobriu Chat, Projects, Artifacts e Research, a Parte 3 cobriu o Domínio 1 — Avaliação e Validação de Resultados, a Parte 4 cobriu o Domínio 2 — Integração de Workflow e Design de Soluções, a Parte 5 cobriu o Domínio 3 — Governança, Risco e Uso Responsável, a Parte 6 cobriu o Domínio 4 — Prompting e Execução de Tarefas. A Parte 8 assume o Domínio 6 — Configuração e Gestão de Conhecimento.