Do que se trata#
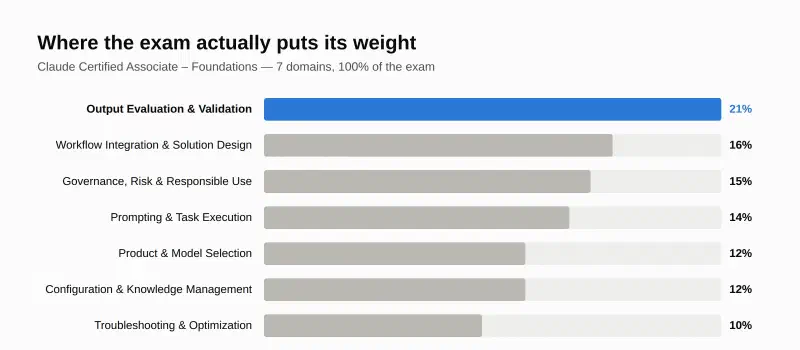
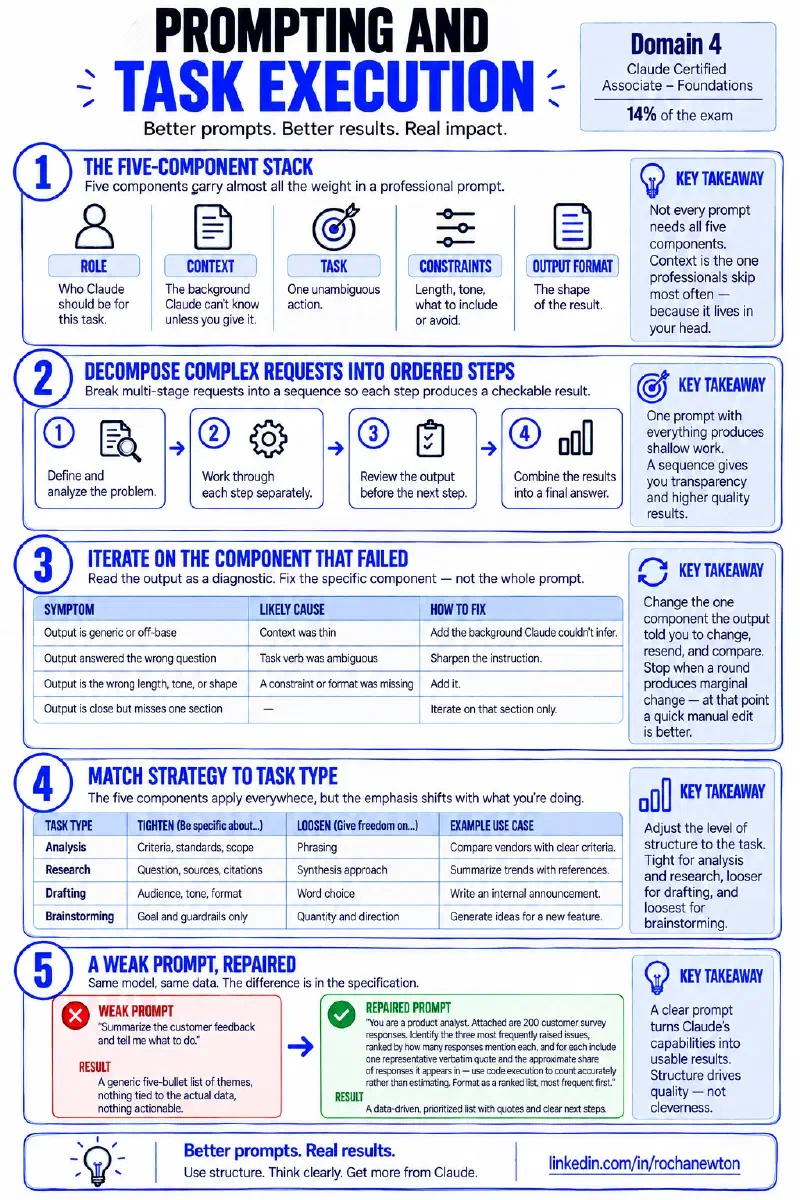
O Domínio 4 da prova Claude Certified Associate – Foundations é Prompting e Execução de Tarefas. Vale 14%. O enquadramento que importa aqui: peça ao Claude “escreva algo sobre nossos resultados do Q3” e você recebe um parágrafo genérico. Especifique o público, os três resultados que importam, o formato e o tamanho, e você recebe um rascunho quase pronto para enviar. O modelo não ficou mais inteligente entre uma solicitação e outra. O prompt que mudou. Este domínio trata prompting como uma disciplina de comunicação com estrutura que se aprende, não um dom que algumas pessoas têm.
Ponto-chave 1: a pilha de cinco componentes#
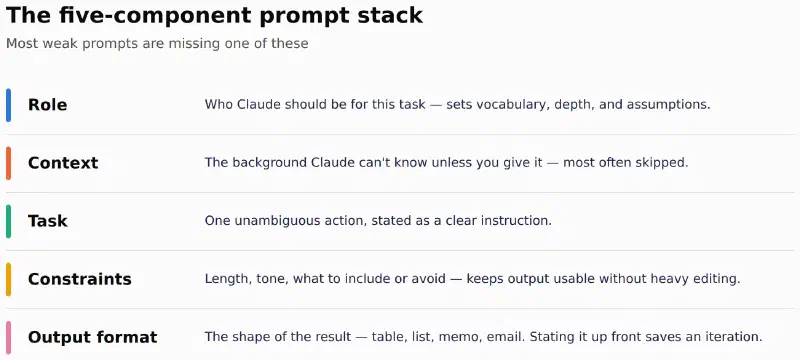
Cinco componentes carregam quase todo o peso de um prompt profissional: Role (quem o Claude deve ser para esta tarefa), Context (o contexto que o Claude não consegue saber a menos que você forneça), Task (uma ação inequívoca), Constraints (tamanho, tom, o que incluir ou evitar), e Output format (o formato do resultado). Nem todo prompt precisa dos cinco — uma pergunta rápida precisa de uma tarefa e talvez uma restrição. Context é o que os profissionais mais pulam, porque ele existe só na sua cabeça e nunca chega ao prompt.
Ponto-chave 2: decomponha solicitações complexas em etapas ordenadas#
Uma solicitação com vários estágios distintos comprimida em um único prompt produz trabalho raso em cada estágio. “Avalie esses três fornecedores e me diga qual escolher” força o Claude a inventar critérios, aplicá-los, ponderar trade-offs e recomendar, tudo em uma única passada — você nunca vê o raciocínio. Divida em uma sequência em vez disso, e cada etapa produz um resultado verificável antes que a próxima rode.
flowchart LR
    A[Derivar critérios
do documento de requisitos] --> B[Pontuar cada fornecedor
contra esses critérios]
    B --> C[Levantar trade-offs
onde os fornecedores mais divergem]
    C --> D[Recomendar
vinculado aos critérios ponderados]

    style A fill:#2a78d6,stroke:#1c5cab,color:#fff
    style B fill:#2a78d6,stroke:#1c5cab,color:#fff
    style C fill:#2a78d6,stroke:#1c5cab,color:#fff
    style D fill:#1c5cab,stroke:#104281,color:#fff
Se os critérios na primeira etapa estiverem errados, você pega isso antes da pontuação, não depois que a recomendação já saiu. Mantenha etapas que se constroem umas sobre as outras em uma única conversa; separe em uma nova conversa só quando uma etapa for genuinamente independente ou quando a thread já tiver crescido o suficiente para o contexto inicial começar a degradar.
Ponto-chave 3: itere no componente que falhou, não no prompt inteiro#
Um primeiro rascunho raramente sai perfeito, e a correção nunca é reescrever o prompt inteiro — isso perde as partes que funcionaram e esconde qual mudança de fato resolveu o problema. Leia o resultado como um diagnóstico em vez disso: ele aponta direto para o componente que falhou.
| Sintoma | Causa provável | Correção |
|---|---|---|
| Resultado genérico ou fora do alvo | Context estava raso | Adicione o contexto que o Claude não conseguiu inferir |
| Resultado respondeu a pergunta errada | Verbo da task era ambíguo | Deixe a instrução mais precisa |
| Resultado com tamanho, tom ou formato errado | Faltou uma constraint ou o format | Adicione |
| Resultado quase certo mas erra em uma seção | — | Itere só nessa seção |
Mude o único componente que o resultado indicou, reenvie e compare. Pare quando uma rodada produzir mudança marginal em vez de melhora real — nesse ponto, uma edição manual rápida vence outra rodada de prompting.
Ponto-chave 4: combine a estratégia com o tipo de tarefa#
Os cinco componentes se aplicam sempre, mas a ênfase muda conforme o que você está fazendo. Análise quer restrições apertadas e critérios explícitos — baixa liberdade criativa, alta especificação. Pesquisa quer escopo claro e disciplina de fontes, com citações que você consegue de fato checar. Redação quer público, tom e formato fixados, com espaço para o Claude encontrar a fraseologia. Brainstorming quer restrições soltas e alta liberdade — superespecificar mata a variedade que você está buscando.
| Tipo de tarefa | Apertar | Soltar |
|---|---|---|
| Análise | Critérios, padrões, escopo | Fraseologia |
| Pesquisa | Pergunta, fontes, citações | Abordagem de síntese |
| Redação | Público, tom, formato | Escolha de palavras |
| Brainstorming | Só objetivo e limites | Quantidade e direção |
Ponto-chave 5: um prompt fraco, reparado#
Fraco: “Resuma o feedback dos clientes e me diga o que fazer.” Resultado: uma lista genérica de cinco bullets com temas, nada vinculado aos dados reais, nada acionável — porque o prompt quase não especificou nada.
Reparado: “Você é um analista de produto (role). Em anexo estão 200 respostas de pesquisa com clientes (context). Identifique os três problemas mais frequentemente levantados, classificados por quantas respostas mencionam cada um (task), e para cada um inclua uma citação verbatim representativa e a proporção aproximada de respostas em que aparece (constraints) — use execução de código para contar com precisão em vez de estimar. Formate como uma lista classificada, do mais frequente para o menos frequente (output format).”
Mesmo modelo, mesmos dados. A diferença entre os dois resultados está inteiramente na especificação, não na capacidade subjacente.
Conclusão#
O Domínio 4 em uma passada: rode todo prompt não trivial contra os cinco componentes (role, context, task, constraints, format), e espere que context seja o que você esqueceu. Decomponha trabalho de múltiplos estágios em etapas ordenadas para que cada uma produza um resultado verificável antes que a próxima rode. Quando o resultado decepcionar, diagnostique qual componente falhou e corrija só aquele — não comece do zero. Combine seu estilo de especificação com a tarefa: apertado para análise e pesquisa, mais solto para redação, o mais solto possível para brainstorming. Estrutura é o que impulsiona a qualidade aqui, não sagacidade.
Fontes#
- Prompting & Task Execution — Anthropic Partner Academy
- Claude Certified Associate – Foundations Exam Guide — PDF oficial
Onde isso se encaixa#
Parte 6 de Getting Claude Certified. A Parte 1 cobriu o Framework 4D, a Parte 2 cobriu Chat, Projects, Artifacts e Research, a Parte 3 cobriu o Domínio 1 — Avaliação e Validação de Resultados, a Parte 4 cobriu o Domínio 2 — Integração de Workflow e Design de Soluções, a Parte 5 cobriu o Domínio 3 — Governança, Risco e Uso Responsável. A Parte 7 assume o Domínio 5 — Seleção de Produto e Modelo.