Do que se trata#
O Domínio 1 da prova Claude Certified Associate – Foundations é Avaliação e Validação de Resultados. Vale 21% — mais do que qualquer outro domínio da prova. O domínio inteiro se resume a uma ideia: resultado com boa aparência não é a mesma coisa que resultado validado. Um texto fluente e confiante não diz nada sobre se está de fato correto. Este post detalha o framework para fechar essa lacuna de propósito, em vez de por acidente.
Por que esse domínio pesa mais que qualquer outro#
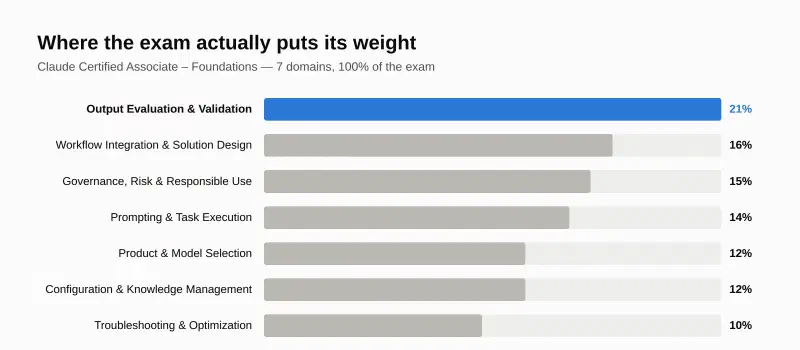
Um retrato rápido da prova em si, do guia oficial de exame da Anthropic:
| Duração | 120 minutos |
| Questões | 60 |
| Preço | US$ 99 |
| Nota de corte | 720 (escala de 100–1.000) |
Ponto-chave 1: cheque o resultado contra três referências, não uma#
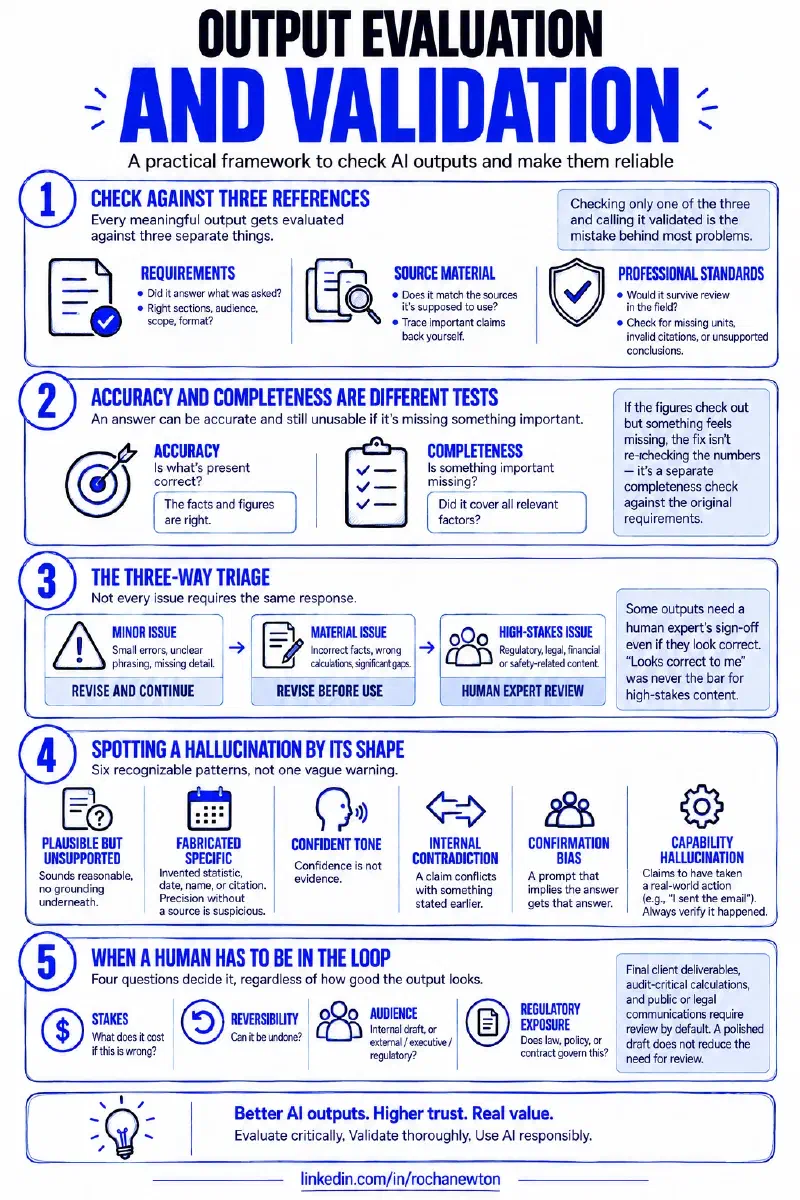
Todo resultado relevante é avaliado contra três coisas separadas:
- Requisitos — ele respondeu o que realmente foi pedido? Seções certas, público certo, escopo certo, formato certo.
- Material-fonte — bate com aquilo que deveria usar como base? Não assuma que o Claude “leu corretamente” — rastreie você mesmo as afirmações importantes.
- Padrões profissionais — sobreviveria a uma revisão na área em questão? Um número sem unidade, uma citação que ninguém encontra, uma conclusão que nada sustenta — isso passa numa leitura casual e não passa numa leitura de verdade.
Checar só uma das três e chamar de validado é o erro por trás da maior parte do que vem a seguir.
Ponto-chave 2: precisão e completude são testes diferentes#
Precisão pergunta: o que está presente está correto? Completude pergunta: falta algo importante? Uma resposta pode ser totalmente precisa e ainda assim inutilizável porque deixou de fora um fator que importava. Se os números batem mas algo parece faltando, a correção não é reconferir os números de novo — é rodar uma checagem de completude separada contra os requisitos originais.
Ponto-chave 3: a triagem em três vias#
Todo resultado cai em um de três grupos:
flowchart TD
    A[Resultado produzido] --> B{Requisitos cumpridos?
Checagens de fonte passam?
Padrão profissional OK?}
    B -->|Sim, risco aceitável| C[Pronto para uso]
    B -->|Lacuna específica e corrigível| D[Precisa de revisão]
    B -->|Risco, exposição regulatória
ou responsabilidade exige| E[Precisa de decisão humana]
    D -->|Corrige e checa de novo| B
    E -->|Humano decide,
independente da qualidade| F[Revisão humana]

    style C fill:#1baf7a,stroke:#0d8a5c,color:#fff
    style D fill:#eda100,stroke:#c98500,color:#fff
    style E fill:#e34948,stroke:#c73b3a,color:#fff
A distinção que importa é entre as duas últimas caixas. Um subtotal errado precisa de revisão — corrija e siga em frente. Uma interpretação regulatória destinada a uma submissão oficial precisa da assinatura de um especialista humano mesmo que pareça completamente correta para você, porque “parece correto pra mim” nunca foi o critério para esse tipo de resultado.
Ponto-chave 4: reconhecendo uma alucinação pelo formato#
Seis padrões reconhecíveis, não um aviso vago:
- Afirmação plausível mas sem sustentação — soa razoável, sem embasamento por trás
- Especificidade fabricada — uma estatística, data, nome ou citação inventada. Precisão sem fonte é suspeita, não tranquilizadora
- Tom confiante mascarando incerteza — confiança não é evidência
- Contradição interna — um número ou premissa afirmado no início conflita com outro afirmado depois
- Viés de confirmação no enquadramento — um prompt que insinua a resposta recebe essa resposta
- Alucinação de capacidade — o Claude diz “enviei o e-mail” ou “salvei o arquivo” quando nenhuma ferramenta capaz disso estava disponível. Sempre verifique se a ação aconteceu
Ponto-chave 5: quando um humano precisa estar no circuito#
Quatro perguntas decidem isso, independente de quão bom o resultado pareça:
- Risco — quanto custa se isso estiver errado?
- Reversibilidade — pode ser desfeito?
- Público — rascunho interno, ou externo / executivo / regulatório?
- Exposição regulatória — isso é regido por lei, política ou contrato?
Entregas finais para clientes, cálculos críticos para auditoria e comunicações públicas ou jurídicas caem, por padrão, no território de “revisão obrigatória.” Um rascunho bem-acabado não reduz a necessidade de revisão — pelo contrário, acabamento é o que faz algo ser aprovado sem revisão nenhuma.
Mais algumas checagens que valem a pena saber#
- Code Execution calcula, não valida a lógica. Use para totais, projeções e qualquer coisa que precise ser calculada em vez de estimada — mas um resultado calculado ainda não é automaticamente uma metodologia correta.
- Curadoria de entrada é parte da validação, não um preparo prévio. Material-fonte ruidoso e contraditório produz saída ruidosa. Um modelo maior não resolve isso — eliminar duplicatas e rotular suas fontes resolve.
- Os mesmos fatos, entregas diferentes. Um executivo quer a decisão e o impacto primeiro. Um time de trabalho quer o método e quem é responsável. Um público externo precisa de divulgação controlada. Mandar o mesmo rascunho bruto para os três falha com pelo menos dois deles.
Conclusão#
O Domínio 1 é a seção de maior peso da prova de certificação Claude porque avaliação é a habilidade de verdade — não prompting, não design de workflow. A versão curta: cheque o resultado contra requisitos, fonte e padrão profissional; trate precisão e completude como testes separados; faça a triagem entre pronto / precisa de revisão / precisa de um humano; conheça os seis padrões de alucinação; e conheça as quatro perguntas que forçam revisão humana independente de quão bom o resultado pareça. Isso é o domínio inteiro, e é a parte de trabalhar com o Claude que mais compensa.
Fontes#
- Claude Certified Associate – Foundations Exam Guide — PDF oficial
- Claude Certified Associate – Foundations Prep Course — módulo “Evaluating & Validating Claude’s Output”
Onde isso se encaixa#
Parte 3 de Getting Claude Certified. A Parte 1 cobriu o Framework 4D, a Parte 2 cobriu Chat, Projects, Artifacts e Research. A Parte 4 assume o Domínio 2 — Integração de Workflow e Design de Soluções.