Do que se trata#
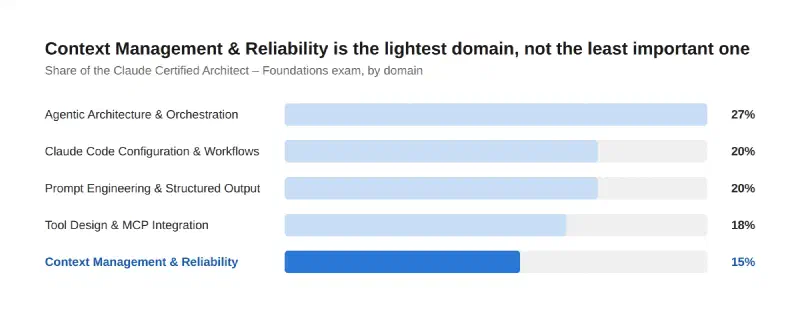
O Domínio 5 — Context Management & Reliability — é o domínio mais leve da prova Claude Certified Architect – Foundations, com 15%, mas suas seis áreas de tarefa cobrem o que decide se um agente de execução longa permanece confiável: preservar fatos críticos ao longo de interações longas, saber quando escalar, permitir que um sistema multiagente se recupere de falhas em vez de degradar silenciosamente, gerenciar contexto em escala, e calibrar o quanto confiar na saída.
Ponto-chave 1: a sumarização progressiva apaga silenciosamente os fatos que importam#
Condensar uma conversa longa numa sumarização é onde a informação morre: datas, percentuais e a expectativa exata declarada por um cliente são suavizadas numa prosa vaga, e a tendência do próprio modelo de “lost in the middle” significa que qualquer coisa enterrada no meio de uma entrada longa é menos confiável do que o que está perto do início ou do fim. A correção no nível de arquiteto é parar de tratar a sumarização como o único mecanismo — extrair fatos transacionais para um bloco estruturado e persistente (um registro de “fatos do caso”) que sobrevive independentemente do resumo narrativo, aparar a saída verbosa de ferramentas antes que ela se acumule em vez de depois, e colocar resumos no início do prompt para trabalhar a favor do efeito de posição, não contra ele.
Ponto-chave 2: escalonamento precisa de gatilhos explícitos, não sentimento ou pontuação de confiança#
Nem a análise de sentimento nem a própria pontuação de confiança do modelo são sinais confiáveis de quando encaminhar para um humano — ambos podem parecer calmos num caso que na verdade está travado, ou ansiosos num que não está. A correção da prova é ter critérios explícitos de escalonamento apoiados por exemplos few-shot: um pedido explícito do cliente por um humano é honrado imediatamente, uma exceção ou lacuna de política escala em vez de ser contornada, e múltiplas correspondências ambíguas de cliente disparam um pedido por outro identificador em vez de uma seleção por melhor palpite. A distinção que importa na prática: reconheça a frustração quando ela estiver presente, mas não trate a frustração em si como o gatilho de escalonamento quando a questão é de fato resolúvel.
Ponto-chave 3: propagação estruturada de erros é o que permite que um coordenador realmente se recupere#
Um status genérico de “falhou” lançado por um subagente esconde tudo que um coordenador precisaria para agir com inteligência. O padrão que este domínio testa: retornar contexto de erro estruturado — tipo de falha, e quais alternativas existem — em vez de um status simples; distinguir uma falha de acesso genuína de um resultado válido, porém vazio, já que colapsar essas duas coisas em “sem dados” produz a decisão de recuperação errada; tentar recuperação local dentro do subagente antes de propagar qualquer falha para cima; e, ao sintetizar resultados de vários subagentes, anotar a saída com lacunas de cobertura em vez de apresentar silenciosamente resultados parciais como completos.
flowchart TD
    A[Tarefa do subagente falha] --> B{Recuperável localmente?}
    B -->|Sim| C[Tentar de novo / fallback
dentro do subagente]
    C --> D[Retornar resultado]
    B -->|Não| E[Retornar erro estruturado:
tipo de falha + alternativas]
    E --> F[Coordenador decide:
tentar de novo, redirecionar, ou anotar lacuna]

    style D fill:#28c840,stroke:#1c9c30,color:#fff
    style E fill:#2a78d6,stroke:#1c5cab,color:#fff
    style F fill:#1c5cab,stroke:#14417f,color:#fff
Ponto-chave 4: exploração de bases de código grandes precisa da própria disciplina de contexto#
Sessões estendidas degradam — a prova nomeia isso diretamente, descrevendo uma degradação de contexto que produz respostas inconsistentes quanto mais longa a sessão fica. As contramedidas são concretas: arquivos scratchpad que persistem descobertas-chave através de fronteiras de contexto, para que sobrevivam mesmo que a sessão não sobreviva; gerar subagentes para isolar exploração verbosa, para que o ruído de buscar numa base de código grande nunca entre na conversa principal; resumir as descobertas de uma fase antes de delegar a próxima, em vez de deixar a exploração bruta se acumular; projetar exportações de estado especificamente para recuperação de falhas; e usar o comando /compact do Claude Code durante uma sessão longa para recuperar espaço com instruções sobre o que preservar, em vez de deixar a auto-compactação adivinhar.
Ponto-chave 5: calibre confiança e preserve proveniência — não confie numa métrica agregada#
Uma métrica de acurácia agregada pode esconder um modelo excelente num tipo de documento e não confiável em outro; a correção é amostragem aleatória estratificada entre segmentos, não um único percentual geral, mais pontuações de confiança em nível de campo calibradas contra um conjunto de dados rotulado, para que extrações de baixa confiança sejam roteadas para revisão humana antes de serem entregues. A mesma disciplina se aplica à síntese multi-fonte: a atribuição de fonte se perde no momento em que um fato é resumido sem sua origem, então mapeamentos estruturados de afirmação-para-fonte (URL, trecho, data de publicação) precisam sobreviver intactos à síntese, estatísticas conflitantes de fontes confiáveis devem ser mostradas lado a lado com atribuição em vez de silenciosamente mescladas num único número, e qualquer coisa sensível ao tempo precisa carregar sua data de coleta ou publicação em vez de ser apresentada como atual.
O quanto isso pesa#
Conclusão#
O Domínio 5 em uma passada: a sumarização apaga silenciosamente fatos concretos a menos que você os extraia para um registro estruturado que sobrevive independentemente, e o efeito lost-in-the-middle significa que a posição no prompt importa tanto quanto o conteúdo. Escalonamento precisa de gatilhos explícitos, apoiados por exemplos — sentimento e pontuações de confiança não são sinais confiáveis por si só. Propagação estruturada de erros, com uma distinção real entre falha e vazio-mas-válido, é o que permite que um sistema multiagente se recupere em vez de degradar silenciosamente. Exploração de bases de código grandes precisa de scratchpads, isolamento por subagente e compactação deliberada para evitar a deterioração do contexto. E a confiança na saída vem de amostragem estratificada e pontuações de confiança calibradas, não de um número de acurácia agregado — combinada com proveniência que sobrevive à síntese em vez de se dissolver nela.
Fontes#
- Claude Certified Architect – Foundations Exam Guide — declarações de tarefa do Domínio 5
- Context editing — Claude Platform Docs — limpeza automática de resultados de ferramentas, a memory tool
- Manage costs effectively — Claude Code Docs —
/compact, gerenciamento de contexto em sessões longas - Best practices for Claude Code — Claude Code Docs — delegação a subagentes para exploração verbosa
A pesquisa e a checagem de precisão técnica contra a documentação oficial são feitas com apoio de IA; o enquadramento, os julgamentos sobre “o que isso significa para a prova” e eventuais histórias de campo são meus.
Onde isso se encaixa#
Parte 6 de Tornando-se um Claude Architect, seguindo o Domínio 4 — Prompt Engineering & Structured Output. A Parte 7 fecha a série com um quiz interativo de 100 perguntas cobrindo os cinco domínios.