Do que se trata#
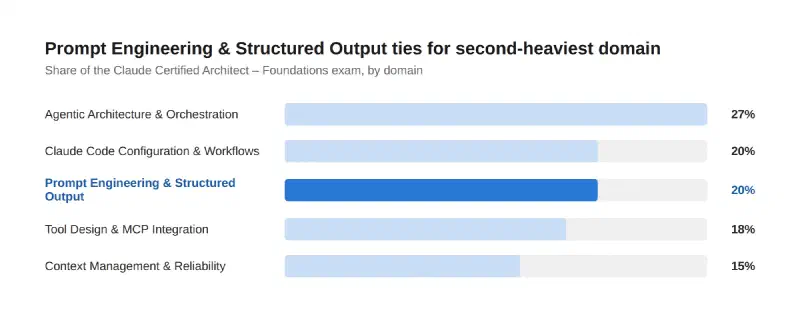
O Domínio 4 — Prompt Engineering & Structured Output — empata com Claude Code Configuration & Workflows como o segundo domínio mais pesado da prova Claude Certified Architect – Foundations, com 20%. Suas seis áreas de tarefa saem de como você escreve um prompt para como você garante que o que volta é de fato utilizável: critérios explícitos, exemplos few-shot, saída reforçada por schema, loops de validação, revisão multi-instância e processamento em lote para escala.
Ponto-chave 1: critérios explícitos vencem instruções vagas, sempre#
A própria documentação de prompting do Claude enquadra bem isso: trate o Claude como um funcionário brilhante, mas novo, que não tem contexto sobre suas normas. “Revise esse código” deixa o Claude adivinhando o que vale a pena sinalizar. “Reporte vulnerabilidades de segurança e erros de lógica; ignore preferências de estilo” não deixa. A versão em nível de arquiteto disso aparece em coisas como classificação de severidade — dar ao Claude critérios concretos do que é crítico versus menor, com exemplos reais de código de cada um — em vez de confiar que ele vai calibrar a severidade a partir de uma instrução de uma linha. O teste que a documentação sugere: mostre seu prompt para um colega com contexto mínimo e veja se ele saberia exatamente o que fazer. Se ele ficaria confuso, o Claude também ficará.
Ponto-chave 2: um punhado de bons exemplos vence uma página de descrição#
Few-shot (multishot) prompting é uma das formas mais confiáveis de guiar formato, tom e estrutura da saída — o Claude generaliza a partir de exemplos concretos de forma muito mais confiável do que a partir de regras abstratas. Para tarefas de extração especificamente, em que os documentos de origem variam em estrutura, 2 a 4 exemplos bem escolhidos cobrindo os cenários ambíguos ou de borda fazem mais para reduzir alucinação do que uma especificação escrita mais longa. Os exemplos precisam merecer o espaço, porém: relevantes (próximos do seu caso de uso real), diversos (cobrindo casos extremos para que o Claude não trave num padrão não intencional), e claramente demarcados do resto do prompt (a documentação do Claude recomenda envolvê-los em tags <example> para que sejam lidos como demonstrações, não instruções).
Ponto-chave 3: tool use com JSON schemas é como você garante o formato da saída#
Pedir educadamente por JSON num prompt de texto te dá JSON na maior parte do tempo. Tool use com um JSON schema — especialmente com strict: true — te dá saída em conformidade com o schema através de decodificação restrita, o que é uma garantia materialmente diferente: sem erros de parsing, sem retentativas por um formato malformado. O tool_choice te dá o controle por cima disso: auto deixa o Claude decidir se chama a ferramenta; any garante que alguma ferramenta seja chamada; e uma escolha forçada prende a uma ferramenta específica. O detalhe que vale internalizar para extração no mundo real: quando documentos de origem podem não conter todos os campos, projete esses campos como opcionais no schema (deixe-os fora de required) em vez de forçar o Claude a inventar um valor só para satisfazer o schema.
Ponto-chave 4: quando a validação falha, devolva o erro — não apenas tente de novo às cegas#
Uma retentativa que reenvia o prompt idêntico depois de uma falha de validação desperdiça uma chamada e frequentemente reproduz o mesmo erro. O padrão mais forte anexa o erro de validação específico ao prompt na retentativa, para que o Claude veja exatamente o que estava errado e possa corrigir diretamente em vez de adivinhar de novo do zero. Parte de projetar isso bem é distinguir erros semânticos (o dado está errado — um campo tem um valor implausível) de erros de sintaxe (o formato está errado — JSON malformado, uma chave obrigatória faltando): eles pedem feedbacks diferentes e, em escala, rastrear quais tipos de erro se repetem mostra onde o schema ou o próprio prompt precisa mudar, não só a lógica de retentativa.
flowchart LR
    A[Gerar saída] --> B{Passa na validação?}
    B -->|Sim| C[Aceitar]
    B -->|Não| D[Anexar erro específico
ao prompt]
    D --> A

    style C fill:#28c840,stroke:#1c9c30,color:#fff
    style D fill:#2a78d6,stroke:#1c5cab,color:#fff
Ponto-chave 5: um modelo revisando sua própria saída é uma checagem mais fraca do que uma instância nova revisando#
A autorrevisão tem uma limitação estrutural: o modelo ainda carrega o contexto de ter gerado aquilo que agora está revisando, o que o torna menos propenso a questionar suas próprias escolhas — ele está preparado para confirmar, não para interrogar. Uma instância de revisão independente, sem memória de ter escrito o trabalho, detecta problemas mais sutis com mais confiabilidade porque não tem nada investido na abordagem original. Para revisões grandes, a mesma ideia escala em revisão multi-passo: dividir o trabalho num passo local (checando cada peça isoladamente) e num passo separado de integração ou cruzamento de arquivos (checando como as peças se encaixam), em vez de esperar que um único passo capture os dois tipos de problema de uma vez.
Uma nota rápida sobre escala: processamento em lote para cargas de trabalho tolerantes a latência#
Fechando o domínio: a Message Batches API troca imediatismo por custo — cerca de 50% de desconto sobre o preço padrão de tokens, com a maioria dos lotes terminando em até uma hora e uma janela máxima de processamento de 24 horas. Ela é feita exatamente para o tipo de trabalho que este domínio aborda: extração em massa, avaliação em larga escala, moderação de conteúdo em volume — qualquer coisa não bloqueante em que um usuário não está esperando a resposta em tempo real. Cada requisição num lote carrega um custom_id, o que importa porque os resultados voltam em ordem arbitrária, não na ordem em que foram enviados; esse mesmo ID é o que permite identificar e reenviar de forma limpa só as requisições que falharam em vez de rodar o lote inteiro de novo.
O quanto isso pesa#
Conclusão#
O Domínio 4 em uma passada: critérios explícitos e verificáveis vencem instruções vagas sempre. Um punhado de exemplos relevantes e diversos guia a saída de forma mais confiável do que uma descrição escrita mais longa. Tool use com um JSON schema estrito é o que de fato garante o formato da sua saída, com tool_choice como o controle e campos opcionais para dados de origem incompletos. Falhas de validação devem devolver o erro específico na retentativa, não apenas repetir o prompt. Instâncias de revisão independentes capturam o que a autorrevisão estruturalmente não consegue. E a Message Batches API é a alavanca para escala assim que a latência deixa de ser uma restrição.
Fontes#
- Claude Certified Architect – Foundations Exam Guide — declarações de tarefa do Domínio 4
- Prompting best practices — Claude Platform Docs — critérios explícitos, exemplos few-shot
- Structured outputs — Claude Platform Docs — tool use estrito, JSON schema, campos opcionais
- Batch processing — Claude Platform Docs — Message Batches API,
custom_id - Best practices for Claude Code — Claude Code Docs — padrão de revisão adversarial/independente
A pesquisa e a checagem de precisão técnica contra a documentação oficial são feitas com apoio de IA; o enquadramento, os julgamentos sobre “o que isso significa para a prova” e eventuais histórias de campo são meus.
Onde isso se encaixa#
Parte 5 de Tornando-se um Claude Architect, seguindo o Domínio 3 — Claude Code Configuration & Workflows. A Parte 6 assume o Domínio 5 — Context Management & Reliability.