Do que se trata#
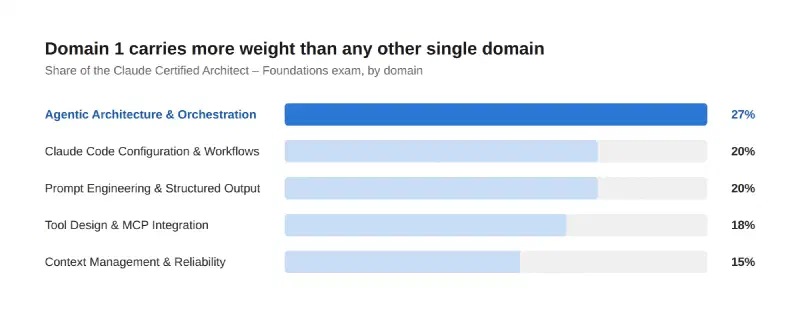
O Domínio 1 — Agentic Architecture & Orchestration — é o domínio mais pesado isolado da prova Claude Certified Architect – Foundations, valendo 27% sozinho. O guia oficial da prova o divide em sete áreas de tarefa: o agentic loop, orquestração multiagente, configuração de subagentes, workflows de múltiplas etapas, hooks do SDK, decomposição de tarefas e gerenciamento de sessão. É muita coisa, então este post condensa tudo nas cinco ideias que realmente carregam o peso, com as duas menores reunidas num resumo rápido no final.
Ponto-chave 1: o agentic loop roda em cima do stop_reason, não interpretando as palavras do Claude#
Todo o agentic loop se resume a um sinal: stop_reason. Sua aplicação envia uma requisição, o Claude responde, e você verifica esse campo. stop_reason: "tool_use" significa que o Claude decidiu chamar uma ou mais ferramentas — você as executa, empacota a saída como blocos tool_result, e envia uma nova requisição com os resultados anexados. O loop se repete enquanto stop_reason == "tool_use". Qualquer outro valor — o mais comum sendo "end_turn" — significa que o Claude produziu sua resposta final e o loop termina.
O ponto no nível de arquiteto aqui é o antipadrão a evitar: não tente detectar “o Claude terminou?” interpretando o texto da resposta em busca de frases como “terminei” ou “aqui está a resposta”. Isso é frágil e depende do modelo. stop_reason é um sinal estruturado e contratual feito exatamente para isso — use-o.
Ponto-chave 2: orquestração multiagente é um hub, não uma malha#
Quando um agente não é suficiente, o padrão cobrado na prova é o hub-and-spoke coordenador/subagente: um único agente coordenador gerencia toda a comunicação entre subagentes, o tratamento de erros e o roteamento de informação. Subagentes não conversam diretamente entre si — tudo passa pelo coordenador. Isso mantém o tratamento de falhas centralizado e evita a bagunça combinatória de cada agente precisar conhecer todos os outros.
Dois hábitos de design importam dentro desse padrão: seleção dinâmica de subagentes (o coordenador decide quais subagentes uma tarefa específica realmente precisa, em vez de sempre acionar todos) e particionamento de escopo — dividir o trabalho para que os subagentes não dupliquem esforço em partes sobrepostas do mesmo problema. Uma orquestração bem projetada também permite loops de refinamento iterativo, onde a saída de um subagente pode disparar uma nova passada em vez de o coordenador tratar todo resultado como final.
flowchart LR
    U[Requisição] --> C[Agente coordenador]
    C --> S1[Subagente A]
    C --> S2[Subagente B]
    C --> S3[Subagente C]
    S1 --> C
    S2 --> C
    S3 --> C
    C --> R[Resultado roteado]

    style C fill:#2a78d6,stroke:#1c5cab,color:#fff
    style S1 fill:#c9ddf6,stroke:#86b6ef,color:#0b0b0b
    style S2 fill:#c9ddf6,stroke:#86b6ef,color:#0b0b0b
    style S3 fill:#c9ddf6,stroke:#86b6ef,color:#0b0b0b
Repare no que não está nesse diagrama: nenhuma seta entre os subagentes. Essa é a disciplina do hub-and-spoke — todo caminho passa pelo coordenador.
Ponto-chave 3: subagentes não herdam contexto, você precisa entregar a eles#
Esse é o detalhe que mais derruba as pessoas: acionar um subagente (via a ferramenta Agent — internamente ainda construída sobre o mecanismo Task, então o allowedTools de um coordenador precisa incluí-la) não entrega automaticamente o histórico da conversa do pai para esse subagente. Um subagente não bifurcado (“fork”) começa do zero — ele recebe seu próprio system prompt e o que você colocar na string de prompt da ferramenta Agent, e nada mais do pai. Nenhum resultado de ferramenta anterior, nenhum raciocínio anterior, nenhum contexto compartilhado presumido.
A implicação arquitetural: se um subagente precisa de um caminho de arquivo, uma mensagem de erro, uma decisão anterior ou qualquer outro detalhe do trabalho já feito pelo pai, esse detalhe precisa ser escrito explicitamente no prompt que você entrega a ele. É também por isso que subagentes são úteis para isolamento de contexto — um subagente de pesquisa pode ler dezenas de arquivos sem que nada desse conteúdo vaze para a conversa principal, porque só a mensagem final dele retorna ao pai. O isolamento e a regra “você precisa passar contexto explicitamente” são o mesmo mecanismo, visto por dois lados.
Ponto-chave 4: para etapas críticas de compliance, aplique com hooks — não peça só no prompt#
Uma instrução no prompt (“sempre valide o valor antes de submeter um pagamento”) é orientação, não garantia — um agente sob pressão de contexto suficiente ainda pode pular essa etapa. Quando uma etapa genuinamente não pode acontecer fora de ordem ou sem verificação — o exemplo do guia oficial é operações financeiras —, a resposta no nível de arquiteto é enforcement programático: hooks e gates de pré-requisito que rodam em código, não na discrição do modelo.
Os hooks do Claude Agent SDK disparam em eventos específicos do ciclo de vida — uma ferramenta prestes a rodar (PreToolUse), uma ferramenta que acabou de retornar (PostToolUse), um subagente iniciando ou parando, entre outros. Um hook de PostToolUse, por exemplo, pode inspecionar e normalizar a saída de uma ferramenta, ou bloquear um resultado não conforme, antes que ele chegue à próxima etapa do agentic loop. A distinção a guardar para a prova: orientação via prompt molda o comportamento de forma probabilística; hooks aplicam de forma determinística. Recorra a hooks quando “provavelmente segue a regra” não for suficiente.
Uma nota rápida sobre escala: decomposição de tarefas e gerenciamento de sessão#
Duas peças menores completam o domínio. Decomposição de tarefas é a escolha entre um pipeline sequencial fixo (encadeamento de prompts — faça A, depois B, depois C, sempre nessa ordem) e decomposição adaptativa, onde a próxima etapa é escolhida com base no que a etapa anterior realmente encontrou. Gerenciamento de sessão cobre retomar uma sessão nomeada para continuar exatamente de onde um agente parou, fork_session para ramificar e explorar uma direção alternativa sem perturbar o histórico da conversa original, e saber quando uma sessão nova com um resumo injetado é melhor do que retomar uma sessão longa (contexto mais curto, mas você controla exatamente o que segue adiante).
O quanto isso pesa#
Conclusão#
O Domínio 1 em uma passada: o agentic loop é uma máquina de estados baseada em stop_reason, não um problema de interpretar texto. Trabalho multiagente deve passar por um coordenador, nunca por uma malha de subagentes. Subagentes começam com contexto em branco — entregue a eles o que precisam explicitamente. Etapas críticas de compliance são aplicadas com hooks, não apenas pedidas num prompt. E decomposição de tarefas/gerenciamento de sessão completam o domínio como peças de apoio em torno dessas quatro ideias maiores. Com 27% da prova, esse é o domínio que mais vale a pena estudar além do necessário.
Fontes#
- Claude Certified Architect – Foundations Exam Guide — declarações de tarefa do Domínio 1
- How tool use works — Claude Platform Docs —
stop_reason,tool_use,end_turn - Subagents in the SDK — Claude API Docs — padrão coordenador, herança de contexto, restrições de ferramenta
- Intercept and control agent behavior with hooks — Claude API Docs —
PreToolUse/PostToolUse - Work with sessions — Claude API Docs — resume vs. fork vs. sessão nova
A pesquisa e a checagem de precisão técnica contra a documentação oficial são feitas com apoio de IA; o enquadramento, os julgamentos sobre “o que isso significa para a prova” e eventuais histórias de campo são meus.
Onde isso se encaixa#
Parte 2 de Tornando-se um Claude Architect, seguindo a visão geral da série. A Parte 3 assume o Domínio 2 — Tool Design & MCP Integration.